如何在 ScreenWeaver 中生成图像和视频:参考图、模型、时长与草稿
用 Image 节点做出一帧最终风格的画面,再用 Video 节点让它动起来,选对模型、时长、分辨率和音频。
章节(10)
视频:免费 AI 电影制作课程 第 5.1 课。 视频为英语讲解。
先图像,后视频
手动操作最适合你想精确控制的单个镜头。专业的顺序是:先做一张有力的静帧,再让它动起来。修一张静帧只要几秒,修一段视频要花一整次生成,而一帧好画面就是你的首帧。
点击工具栏中的 Image 模块,然后在这场戏的 Production 组内点击。新节点会采用项目的画幅比例,因为这个设置只对新建的镜头和图像生成节点生效。
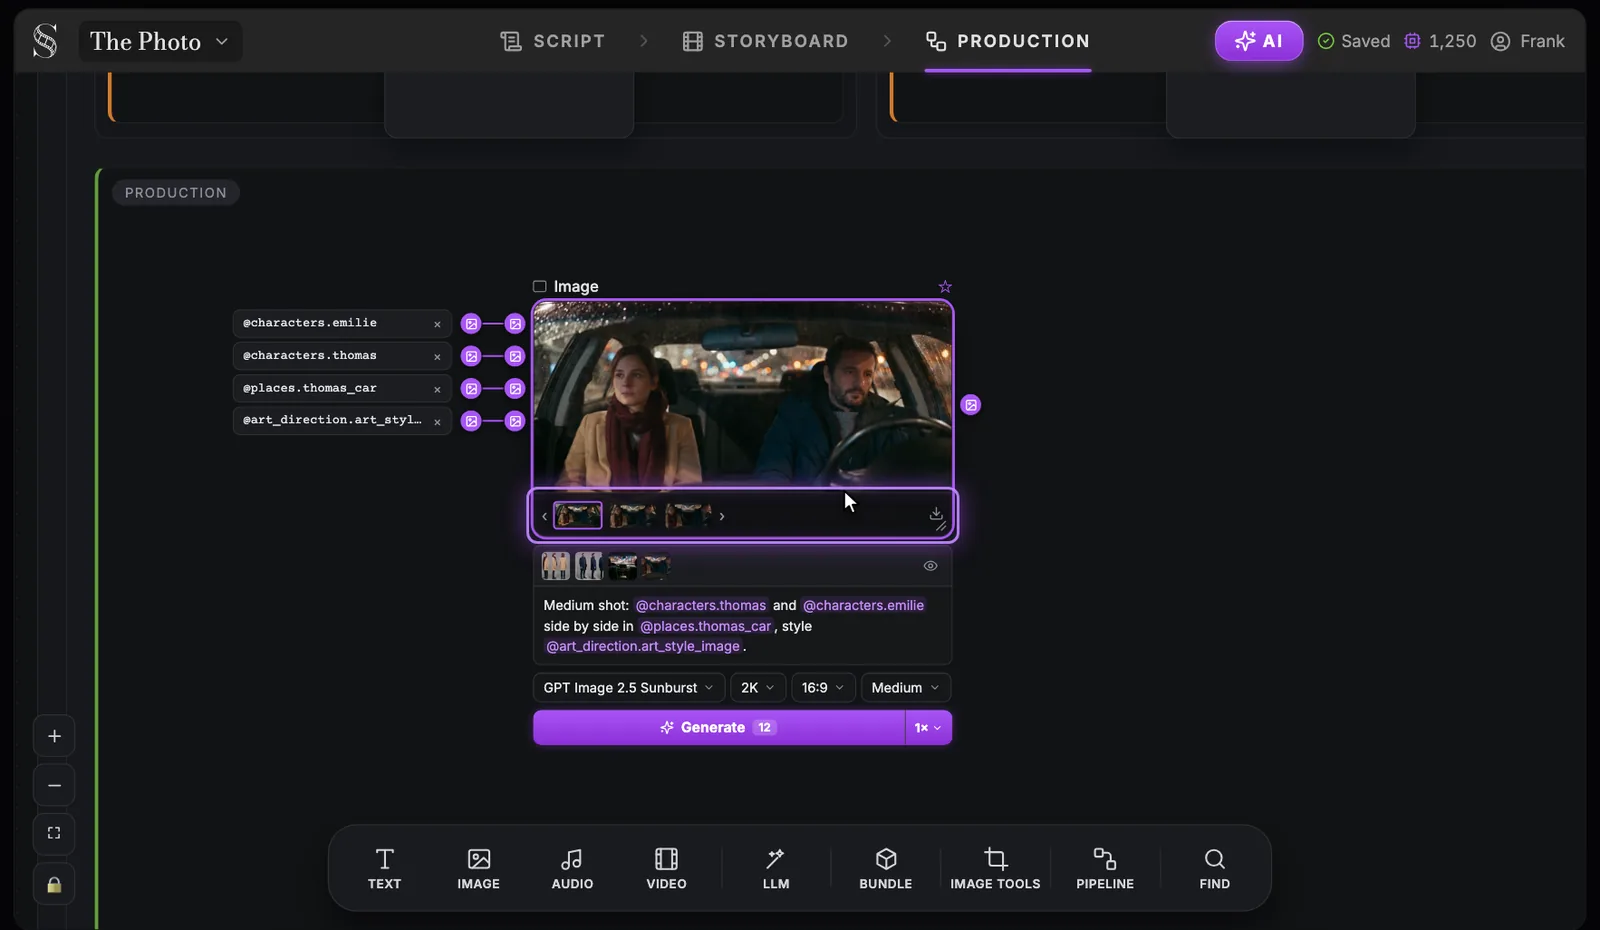
Image 节点,逐个控件讲解
左右滑动可查看完整界面。
- 1参考图. 接入节点的实体设定图和美术风格(@characters、@places、@art_direction)。先把参考图接进来,再在提示词里用它的 @ 引用调用它。
- 2图像预览. 节点的当前图像。它的输出可以作为首帧或参考图,供给视频节点。
- 3素材条. 这个节点生成过的每一张图像。用箭头浏览,用下载图标保存其中一张;再次运行不会抹掉之前的素材。
- 4Show what the model receives(显示模型接收的内容). "Show what the model receives" 切换到发送给模型的最终提示词;"Back to editable prompt" 回到你的文字。当某个结果无视了某条指令时,就来检查一下。
- 5Prompt(提示词). 你的指令,带有对已接入设定图的 @ 引用。把文字花在构图、动作和光线上;视觉风格来自美术风格参考图。
- 6Model(模型). GPT Image 2.5 Sunburst(默认)、Nano Banana 2.1、Seedream 5.0 Pro、GPT Image 2.5 Flare 或 Grok Imagine Image。
- 7Quality(画质). Low、Medium、High、Extra high 或 Max。探索阶段用较低画质,选定的画面再用更高画质渲染,并在 Generate 的提示文字里查看费用。
- 8Generate(生成). 运行节点。积分费用显示在按钮上和提示文字里,任务会出现在 Generations 中。
- 9Images per generation(每次生成的图像数). 每次运行 1、4 或 8 张图像。想挑构图时多生成几张,知道自己要什么之后只生成一张。
- 1接入参考图(标记 1):镜头中角色、地点和道具的制作参考图,外加 Art Style Image。它们以紫色图像连线接入。
- 2写提示词(标记 5)。输入 @ 用引用调用每张参考图,而不用重新描述一遍。
- 3选择模型(标记 6):默认是 "GPT Image 2.5 Sunburst",同一菜单中还有 "Nano Banana 2.1"、"Seedream 5.0 Pro"、"GPT Image 2.5 Flare" 和 "Grok Imagine Image"。
- 4设置 "Quality"(画质,标记 7):Low、Medium、High、Extra high 或 Max。
- 5设置 "Images per generation"(每次生成的图像数,标记 9):1、4 或 8。
- 6点击 Generate(标记 8)。按钮会在你花钱之前显示积分费用。
中景:@characters.thomas 和 @characters.emilie 并排坐在 @places.thomas_car 中,风格 @art_direction.art_style_image。
每次运行的结果都会出现在预览下方的素材条中(标记 3)。留下脸、服装和光线都与设定图一致的那一条。你也可以上传自己的图像来代替。
Video 节点:模式取决于连线
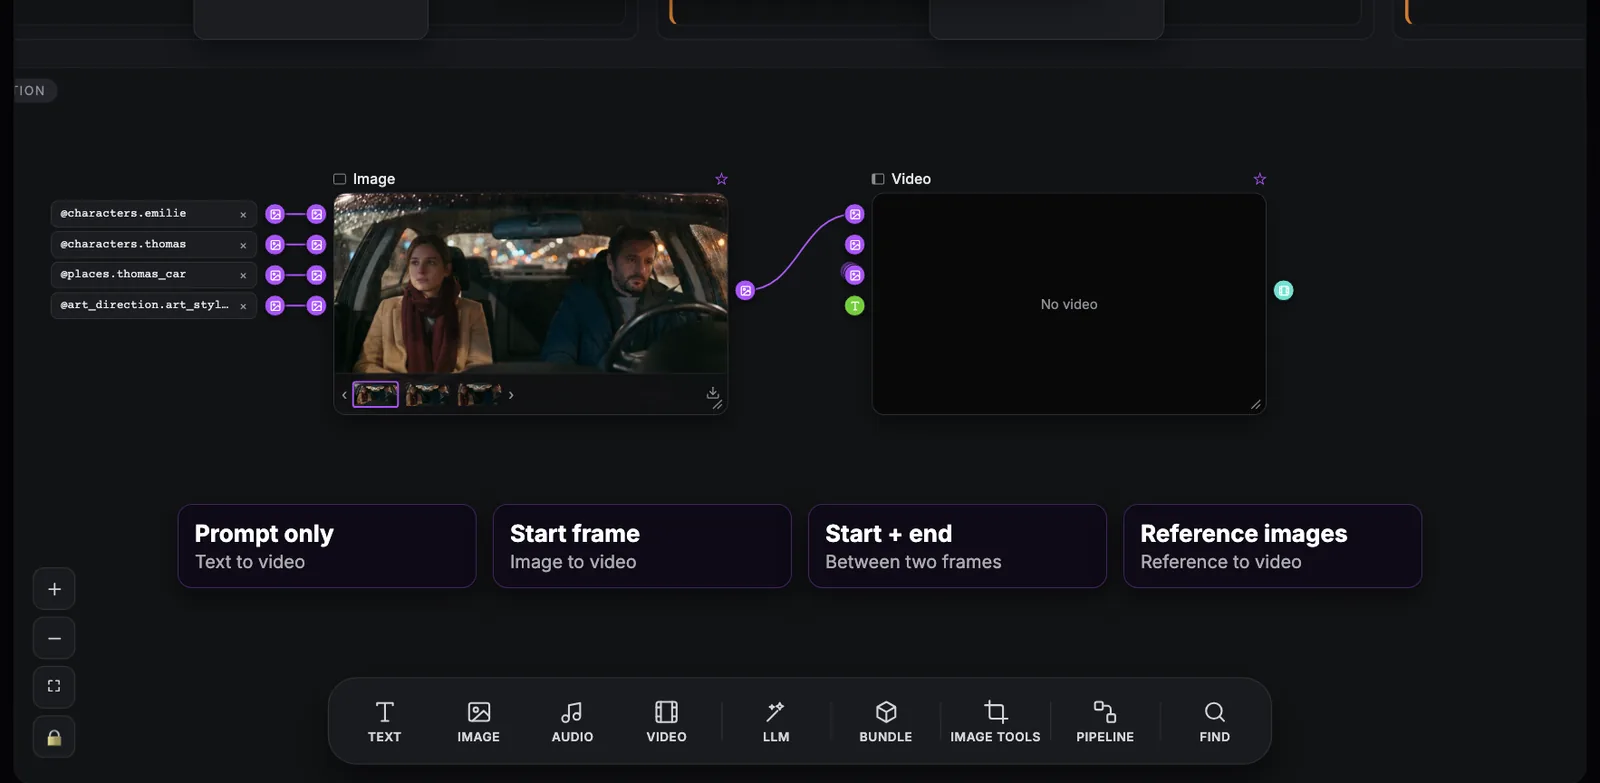
添加一个 Video 节点,你找不到模式切换开关。节点会读取你接入的内容。
左右滑动可查看完整界面。
- 1已连接的图像. 连接到视频节点的一张制作图像。作为首帧,它固定了第一帧,让片段保留你的构图、脸和光线。
- 2输入端口. 节点左侧的端口:"Start frame"、"End frame"、参考图和文字。"Reference images are ignored while a start frame is connected."(接入首帧时,参考图会被忽略。)
- 3视频节点. 生成片段的节点(运行之前显示 "No video")。它的提示词、模型、分辨率、时长和音频控件都在预览下方。
- 4驱动视频的四种方式. Prompt only(文生视频)、Start frame(图生视频)、Start + end(在两帧之间生成)或 Reference images(参考生视频)。各模型有所不同:Kling v3.0 i2v 需要首帧,Veo 3.1 的参考生视频仅支持 8 秒。
- 仅提示词(文生视频):只有文字。自由度最高,一致性最低。
- 首帧(图生视频):接在 "Start frame" 接口上的图像,会成为片段的第一帧。
- 首尾帧(在两帧之间生成):在 "End frame" 接口上再接一张图像,模型会自己找出两帧之间的过渡。
- 参考图(参考生视频):用图像来规定谁和什么会出现,镜头调度则交给模型自己完成。
模型、分辨率、时长和音频
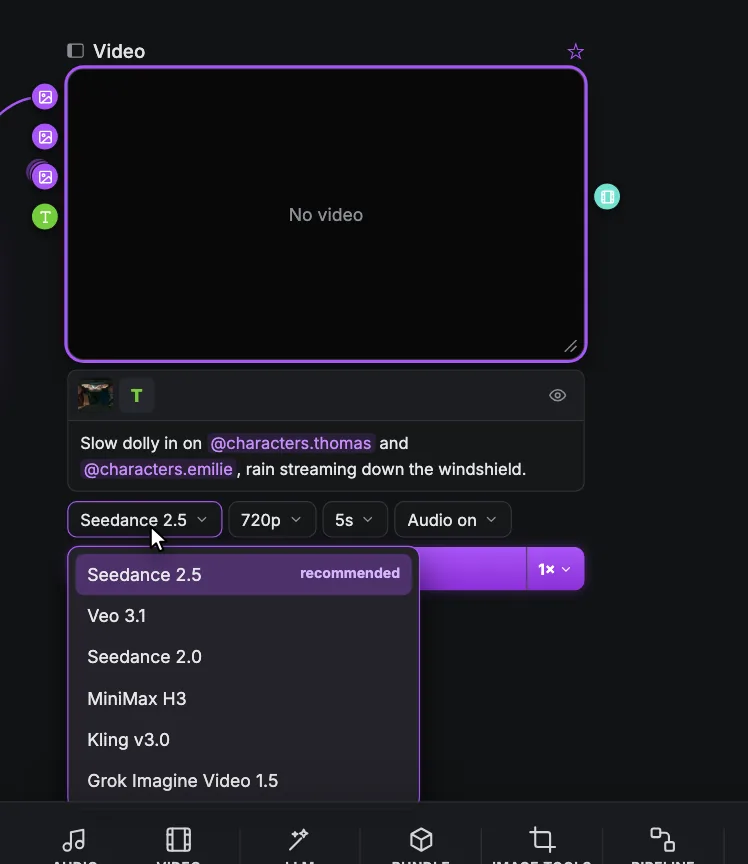
- 1视频节点. 片段预览(运行之前显示 "No video")。它的 "Generation history" 素材条会保留你的各条素材和版本,"Edit video" 可以对结果进行处理。
- 2输入. 首帧、尾帧、参考图和文字的端口。接入首帧时,参考图会被忽略。
- 3Show what the model receives(显示模型接收的内容). 显示发送给模型的最终提示词;"Back to editable prompt" 回到你的文字。
- 4Prompt(提示词). 描述运动、运镜和声音,用 @ 引用角色和地点。计数器("{current} / {max}")会显示模型还允许你写多少。
- 5Model(模型). Seedance 2.5 是默认模型。每项设置都会先显示常用数值,其余的在 "All options" 下面。
- 6视频模型. Seedance 2.5(推荐)、Veo 3.1(仅支持 16:9 和 9:16)、Seedance 2.0、MiniMax H3、Kling v3.0 i2v(需要首帧)、Kling v3.0 t2v、Kling v3.0 Motion Control(没有视频参考时可能被阻塞)以及 Grok Imagine Video 1.5。Kling 模型会多出一个 Mode 选项:Standard 或 Pro。
- 7分辨率. 大多数模型为 720p 或 1080p,MiniMax H3 为 2k,Veo 3.1 的 1080p 和 4k 仅支持 8 秒。Seedance 2.5 额外提供 480p "Draft"("Low-resolution draft for a quick, cheaper preview.",低分辨率草稿,用于更快、更便宜的预览),你可以在 7 天内用 "Finish seedance draft" 把它完成为最终版。
- 8时长. Seedance 2.5 和 2.0:4、5、6、8、10、12 或 15 秒(Seedance 2.5 最长可达 30 秒)。Veo 3.1:4、6 或 8 秒。Kling v3.0:5 或 10 秒。Grok Imagine Video 1.5:4、6、8 或 10 秒。MiniMax H3:5 到 15 秒。按镜头需要来选。
- 9Audio on / off(音频开/关). "Audio on" 或 "Audio off"。MiniMax H3 和 Grok Imagine Video 1.5 始终生成音频;Kling v3.0 Motion Control 没有音频。
设置都在一行里:模型、分辨率、时长和 "Audio on" / "Audio off",然后是带有费用的 Generate。提示词下方有一个计数器,显示当前长度和模型的上限。最先列出的是常用数值,其余的在 "All options" 下面。
- Seedance 2.5(默认):优先显示 4、5、6、8、10、12 或 15 秒,最长 30 秒;720p 或 1080p,外加 480p 草稿(Draft)。
- Veo 3.1:4、6 或 8 秒;720p 或 1080p。1080p 和 4k 仅支持 8 秒,参考生视频仅支持 8 秒,并且只支持 16:9 和 9:16。
- Seedance 2.0:4、5、6、8、10、12 或 15 秒;720p 或 1080p。
- MiniMax H3:5 到 15 秒;2k;音频始终开启。
- Kling v3.0 i2v:5 或 10 秒;720p 或 1080p;需要首帧;Mode 可选 Standard 或 Pro。
- Kling v3.0 t2v:5 或 10 秒;720p 或 1080p;Mode 可选 Standard 或 Pro。
- Kling v3.0 Motion Control:5 或 10 秒;720p 或 1080p;无音频;没有视频参考时可能被阻塞。
- Grok Imagine Video 1.5:4、6、8 或 10 秒;720p 或 1080p;音频始终开启。
叙事场景推荐使用 Seedance 2.5,但没有最好的模型,只有最适合某个镜头的模型。用相同的参考图和提示词,在两三个模型上测试同一个镜头,然后给结果打分。
先做草稿,只给胜出的那条做最终版
在 Seedance 2.5 的分辨率菜单中,"480p · Draft" 是 "Low-resolution draft for a quick, cheaper preview."(低分辨率草稿,用于更快、更便宜的预览)。用它来测试运动和表演。先把各条素材都生成为草稿,选出最好的一条,再用 "Finish seedance draft" 得到 1080p 版本。草稿在 7 天内可以完成最终版,所以要保留的素材请在同一周内完成。
"Video tools" 下的 Upscale 工具也能通过 "Seedance 2.5 Draft finish" 做同样的事,之后还能用 Topaz 把完成的视频放大到 1080p 或 4k。这一步会在 成片与交付 中讲解。
像导演一样写视频提示词
模型会用默认值填满每一处你没写的空白。每个镜头都按同样的顺序来写:摄影机、主体、动作、表演、环境与光线,最后是声音和约束条件。
中景双人镜头,缓慢推镜。@characters.thomas 坐在 @places.thomas_car 的驾驶座上,@characters.emilie 坐在副驾驶座,后排座位空着。Thomas 转向 Émilie,递出一张旧照片;她双手接过。她的眼中涌出泪水,随后露出一丝浅浅的微笑。夜晚,雨水持续打在挡风玻璃上,柔和的街灯光。只有自然的车内环境音和雨声,没有配乐,没有字幕,没有屏幕文字。
- 一定要写明运镜方式及其速度,否则模型会替你选一个:这就是所谓的 “飘忽镜头”。
- 按镜头的时长来写动作:五秒钟只容得下两三个小动作。
- 把情绪写成摄影机能拍到的行为,而不是一种感受。
- 如果一个片段里有好几个镜头,就写一条时间线(0 到 5 秒,然后 5 到 9 秒),并写明镜头之间是硬切。
声音要逐个镜头决定。"Audio on" 可以在素材里直接带上对白和环境音;如果你打算自己做声音设计,就选择 "Audio off"。
多条素材与历史记录
Video 节点会保留一条 "Generation history"(生成历史)素材条,所以第二次尝试永远不会抹掉第一次。重新生成时一次只改一处;同时改三处,你就永远不知道是哪一处修好了镜头。
现在就动手
在 ScreenWeaver 中练习
- 1在某场戏的 Production 组中添加一个 Image 节点,接入镜头的参考图,写一段带 @ 引用的提示词。
- 2先生成 1 张图,调整提示词,然后生成 4 张,留下最好的一条。
- 3把这张图接入一个新 Video 节点的 "Start frame",按六段式顺序写提示词。
- 4用 Seedance 2.5 以 "480p · Draft" 生成两条素材,选一条并完成为 1080p。
- 5打开 "Show what the model receives",对照提示词检查每一张参考图。
观看视频课程
关于这一步的问题
在 ScreenWeaver 里应该用哪个视频模型?
先用默认的 Seedance 2.5:片段 4 到 30 秒,720p 或 1080p,并有 480p 草稿。在保持参考图和美术指导完全相同的前提下做过并排测试之后,再为特定镜头换模型。
为什么视频忽略了我的参考图?
因为接入了首帧。只要 "Start frame" 接口上有图像,参考图就会被忽略,所以应该改进首帧。
能生成 4K 视频吗?
Veo 3.1 可以为 8 秒片段输出 4k。其他模型,请先完成你要保留的那一条,然后在 Upscale 视频工具中用 Topaz 把它放大到 4k。
Seedance 草稿的有效期是多久?
草稿在 7 天内可以完成最终版。过期之后草稿失效,需要重新生成这个镜头。
为什么我的片段带了音乐或字幕?
模型填补了你提示词里的空白。在每条提示词的结尾写明你的声音要求和约束条件,或者把节点设为 "Audio off"。
一次能生成多少张图像?
"Images per generation" 提供 1、4 或 8 张。在你点击之前,Generate 按钮会显示所选数量对应的积分费用。