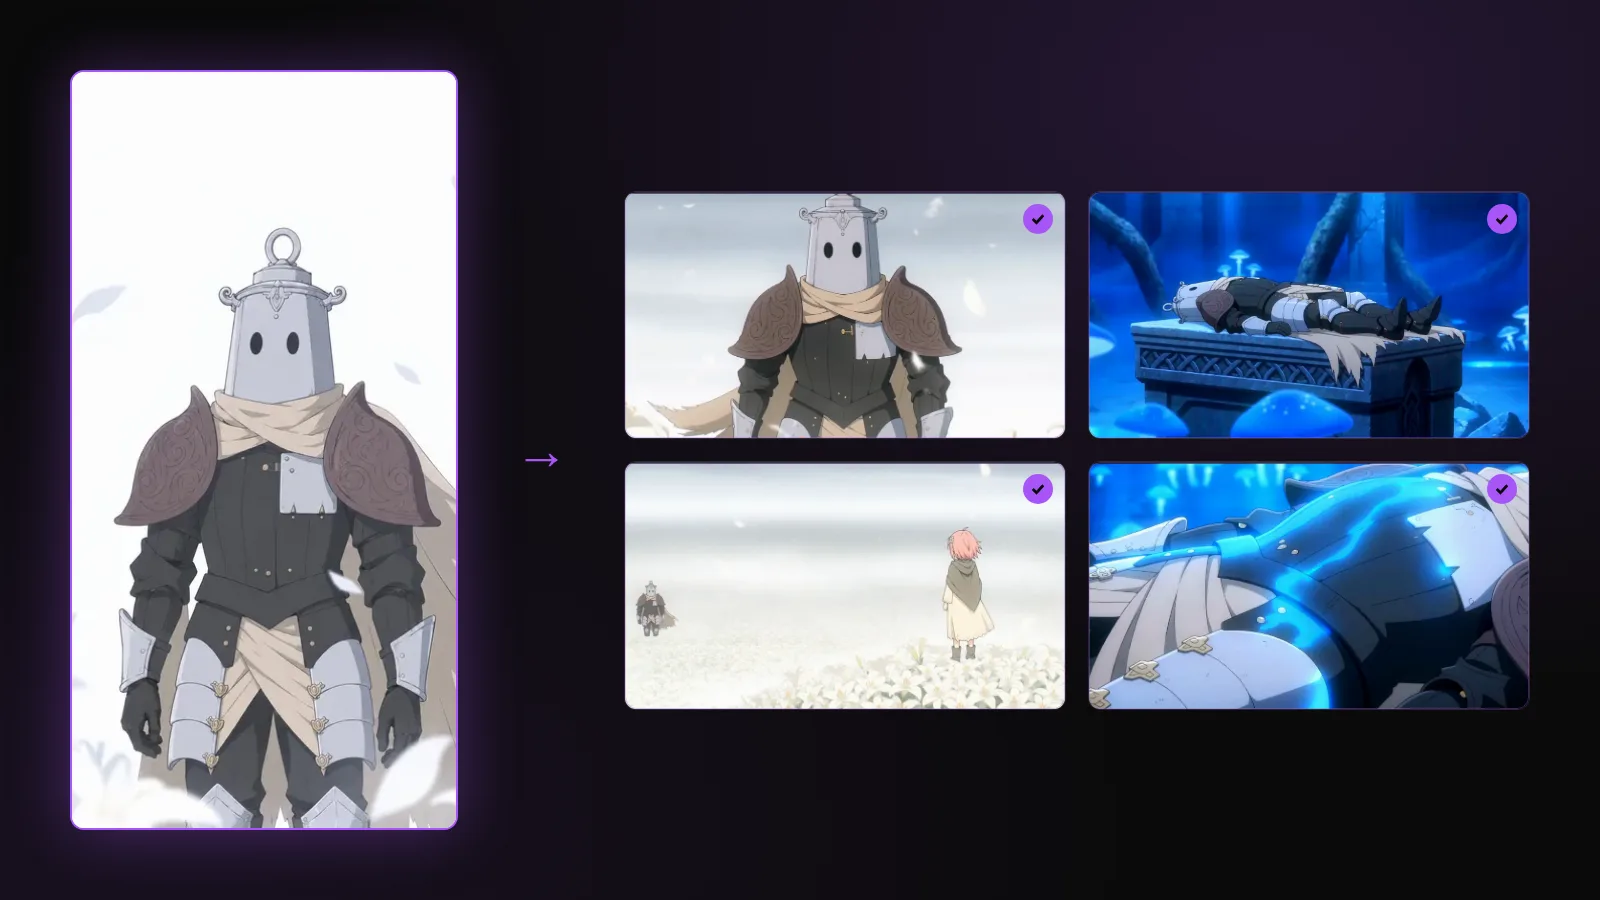
用AI把条漫做成动画,要按顺序做四件事:把一话拆成场景和镜头,直接用画格建立角色和风格参考,生成使用这些参考的16:9分镜,然后把每一帧分镜变成一段短视频,再剪到一起。画格就是输入,剧本可有可无。
这是实操篇。想先看全局,包括动画公司怎么做、你到底该不该尝试,请从条漫怎么改编成动画开始。如果你不想手工重建每一个镜头,ScreenWeaver可以直接导入一话:你发送页面,画格会作为镜头返回,然后你在应用里生成它们。下面的MCP一节展示了它在一部真实作品上的运作方式,条漫转动画页面有概要。
你真正在转换的是什么
一话条漫是一条由60到90格组成的竖向长条。一集动画是一串有时长的镜头。把每一格依次做成动画,这种思路本身就是错的。转换其实是一系列作者从来不需要做的决定:
| 条漫里有 | 动画需要 | 谁来决定 |
|---|---|---|
| 画格 | 镜头(一格可能是两个镜头,三格可能是一个) | 你 |
| 阅读顺序 | 剪辑顺序,通常相同,偶尔不同 | 你 |
| 格间留白(画格之间的空白) | 时长,以及这段时间里什么在动 | 你 |
| 对白气泡 | 有说话人、有时长、有表演的台词 | 你,然后是配音 |
| 800px宽的竖向画布 | 16:9画面,意味着每一格都要重新构图 | 你,借助工具 |
| 被统一地画了400次的角色 | 一套锁定的参考,让生成始终符合设定 | 工具,基于你的画格 |
| 一套配色和线条风格 | 应用到每一帧的风格参考 | 工具,基于你的画格 |
标着“工具”的两行,是AI在过去一年里解决的问题。其余都是导演工作,仍然需要人来做。
捷径:通过ScreenWeaver MCP导入一话
下面五个手工步骤仍然解释了每一个决定,但你已经不必把它们全部手动输入。ScreenWeaver的MCP服务器,以及应用内置的助手,会接收各页图片、裁出画格,并起草角色阵容和镜头,供你修改。代码字体的名称是助手调用的工具,它工作时你会在Claude或ChatGPT里看到这些名称一一闪过。
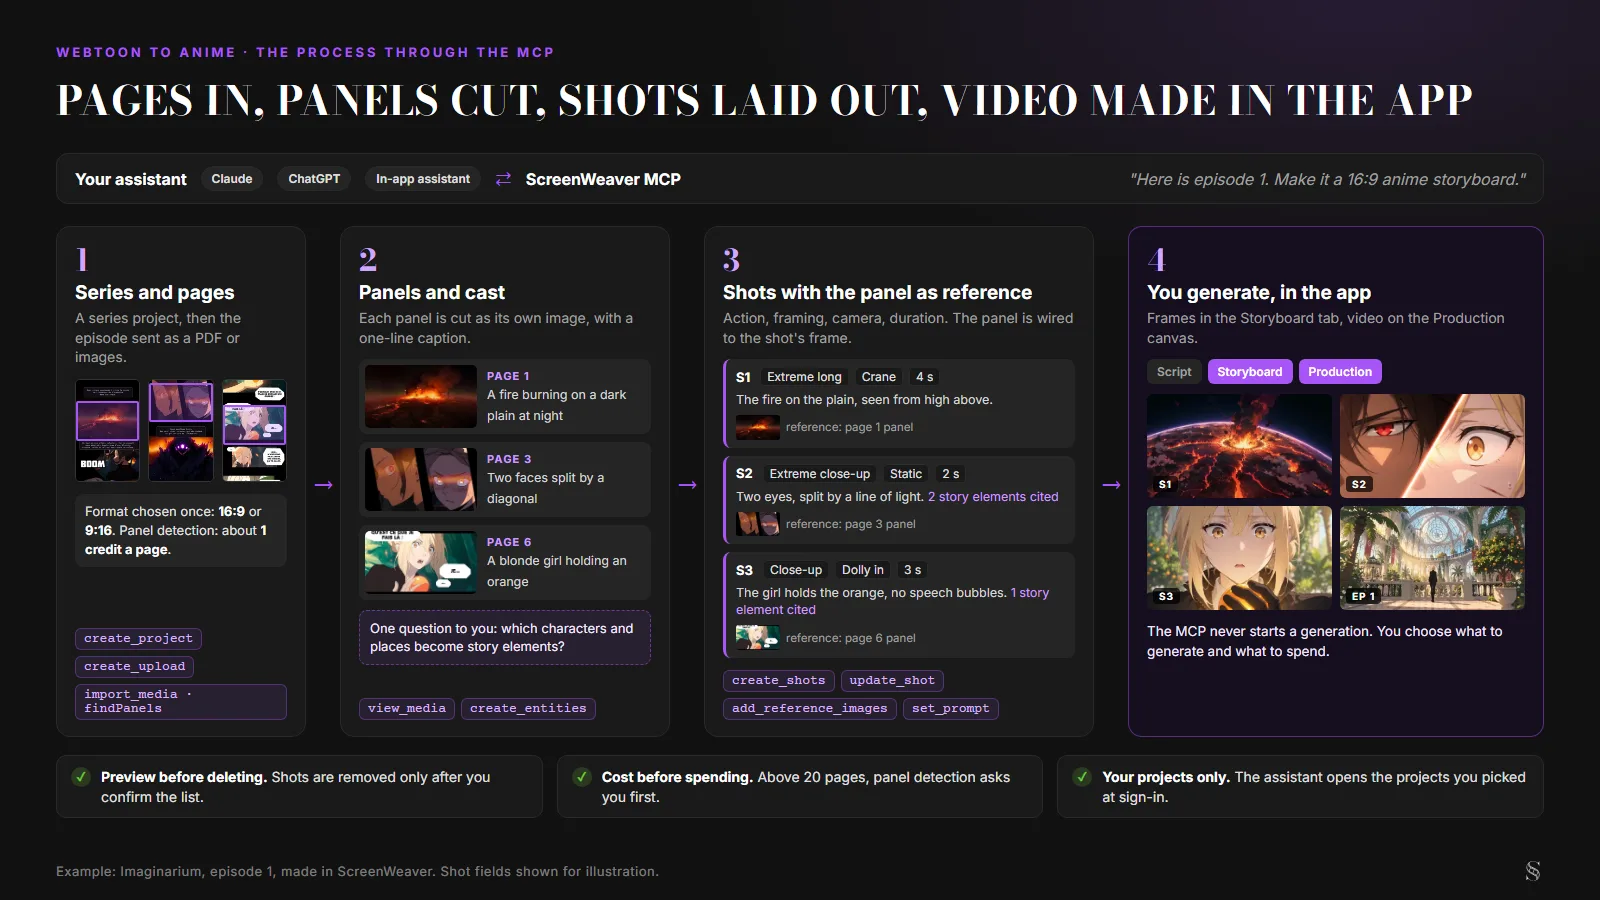
以Imaginarium为例的流程,这是一部在ScreenWeaver中改编的条漫。画格和镜头是真实的,镜头字段仅作示意。
- 连接。 把服务器
https://app.screenweaver.ai/api/mcp作为自定义连接器添加到Claude或ChatGPT,或者使用账户Connected apps中的Add to Claude链接。登录ScreenWeaver,选择助手可以打开哪些项目。各客户端的设置方法见MCP页面。如果你更想留在应用里,ScreenWeaver内置的助手拥有同样的工具:把页面附加到对话中即可。 - 创建剧集。
create_project创建一个剧集项目并设定画幅,16:9或9:16。助手会问你选哪一个,而不会替你选。镜头隶属于场景,所以它还会用edit_script写出场景标题。 - 导入页面。 通过MCP,文件先用
create_upload上传,再执行带findPanels: true的import_media。视觉模型会在每一页上找出画格,每个画格单独存为一张图片,标注为“Page N, panel K”,并附一行说明它画了什么。支持PDF、PNG、JPEG或WebP,最大25 MB,每次调用最多50页。长条请切成一系列页面高度的图片发送,而不是一个超长文件:在搜索画格之前,每张图片的长边都会被缩小到1,568 px。画格检测每页约1积分;超过20页时调用会暂停,给出预估费用,等你确认。 - 检查裁切。 助手用
view_media查看裁出的图片。模型漏掉或裁坏的画格,会用明确的框从原页面重新裁出。 - 确定角色阵容。 在写任何镜头之前,助手会列出在多个画格中反复出现的角色、地点和道具,问你一次要创建哪些,然后调用
create_entities。这就是下面的第2步,只不过是基于你的画格完成的。 - 排布镜头。
create_shots逐场景写出镜头:一段引用故事元素的动作、一个景别(shotValue)、一种运镜、一个时长。当一格拆成两格时,continuesFrom会把第二个镜头接在第一个后面。之后要单独修改某个镜头,用update_shot。 - 以画格为参考。
add_reference_images把画格挂到该镜头的画面生成器上,set_prompt重写画面提示词:按项目画幅重画这一格,保留构图,角色按参考来画,去掉对白气泡。 - 在应用中生成。 这些工具都不会生成图片或视频。你打开Storyboard标签页生成画面,在Production画布上生成视频片段,这正是下面第4步接手的地方。
从Claude这边看,整个过程就是一场对话,中间只有一个问题:
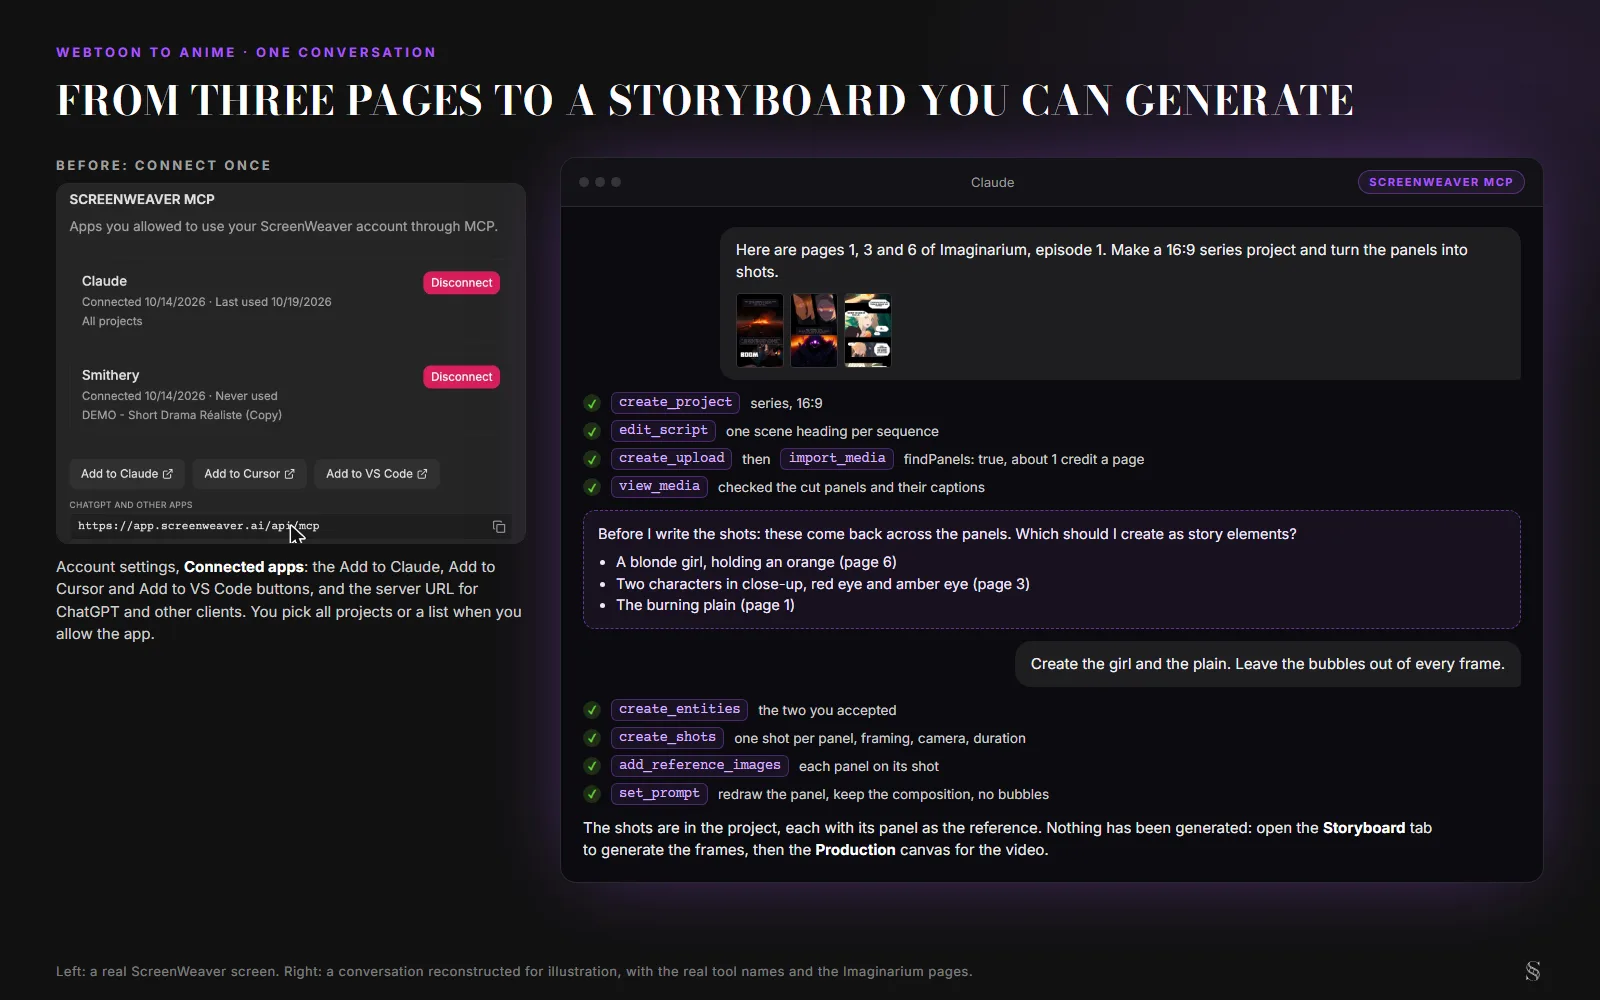
左侧是真实的ScreenWeaver界面。右侧是为说明而重构的对话,使用了真实的工具名称和Imaginarium的页面。
有两条规则来自服务器端,所以即使助手跳过了自己的指令,它们依然有效。删除镜头(delete_shots)会先返回将被删除内容的预览,在你确认之前什么都不做。付费步骤在运行前会先说明费用。在应用中,对助手的单次请求上限为200积分,累计用量显示在Stop按钮旁边。
导入做不到的是导演工作。放任不管的话,助手会紧贴你的画格来做,所以第1步里拆分与合并的决定仍然在你手里。你用提要求的方式来做:“第4到6格是一个镜头”,“把第12格拆成蓄力和击中”。另外,画面是根据你的画格生成的,而不是描摹出来的:构图和角色会延续下来,线条会有些许变化。
第1步:把一话拆成场景和镜头
通读这一话,标出每一次地点或时间的变化。条漫很少写“内景 教室 日”,所以你要从背景里推断。大多数单话有两到五个场景。
在每个场景里决定镜头。默认是一格一个镜头。遇到以下情况就打破默认:
- 一格里有一个带有“之前”和“之后”的动作。画在击中瞬间的一拳至少是两个镜头:蓄力和击中。
- 几格是同一构图、不同对白。同一角色的三格说话特写,是一个带三句台词的镜头。
- 一个高格就是一次运镜。一整格高的塔,是一次上摇,而不是静止画面。
- 一个宽格里有两个视觉焦点。作者希望你的视线移动。那就是一次横摇,或者两个镜头。
在碰任何生成工具之前,先把它写成镜头表:场景、镜头编号、来源画格编号、景别、什么在动、对白。如果你从没写过,景别指南会给你术语。做得好的话,一话75格会得到50到70个镜头,而这个数字比任何其他因素都更能决定你的预算。
如果你更愿意从剧本出发,这份镜头表正好可以粘贴到ScreenWeaver的剧本一侧:场景标题、描述动作的动作行,以及作为对白的气泡文字。剧本会免费给你页数、时长估算和大纲。做试播样片可以跳过这一步;做一季十二集还跳过,你就会迷失进度。
使用助手或MCP时: 画格已经由带findPanels: true的import_media裁好(每页约1积分),create_shots据此免费写出第一版镜头表。上面说的通读由你来做,修改意见以指令的形式给出;update_shot和continuesFrom负责执行。
第2步:用画格建立参考
这是大家最常跳过、然后又纳闷为什么角色每个镜头都换了一张脸的一步。
对每个反复出现的角色,从真正的条漫里截取:
| 参考 | 在画格的哪里找 | 为什么重要 |
|---|---|---|
| 正脸,中性表情 | 任意一格对白特写 | 锚点,生成首先对齐它 |
| 四分之三侧脸 | 几乎每一格反应镜头 | 大多数镜头实际会用到的角度 |
| 侧脸 | 较少见,找走路的格或双人格 | 没有它,模型会自己编一个鼻子 |
| 全身,默认服装 | 交代场景的格、每话开头 | 服装、比例、与其他角色的身高关系 |
| 两三种关键表情 | 作者画得最夸张的地方 | 让情绪幅度保持在设定之内 |
| 其他服装或形态 | 故事引入它的地方 | 否则模型会退回默认形象 |
对两三个反复出现的地点和作品的风格也照此处理:一页内容,展示线条粗细、配色、阴影的画法、背景的简化方式。角色一致性设定表会把这些整理成生成模型最容易响应的版式。
在ScreenWeaver里,这些以故事元素的形式存在:角色、地点和道具,每个都有一张参考设定表。你可以根据描述生成设定表,也可以把自己裁好的画格拖到元素上,用它们来制作。做条漫的话,永远选第二种。作者已经画出了权威参考,生成的近似版只会是降级。
使用助手或MCP时: 助手会根据画格提出反复出现的角色和地点,用create_entities创建你接受的那些,还可以用add_reference_images为每个元素挂上最能展示它的画格。这些都不消耗积分;生成参考设定表本身则会在Storyboard标签页中消耗积分。
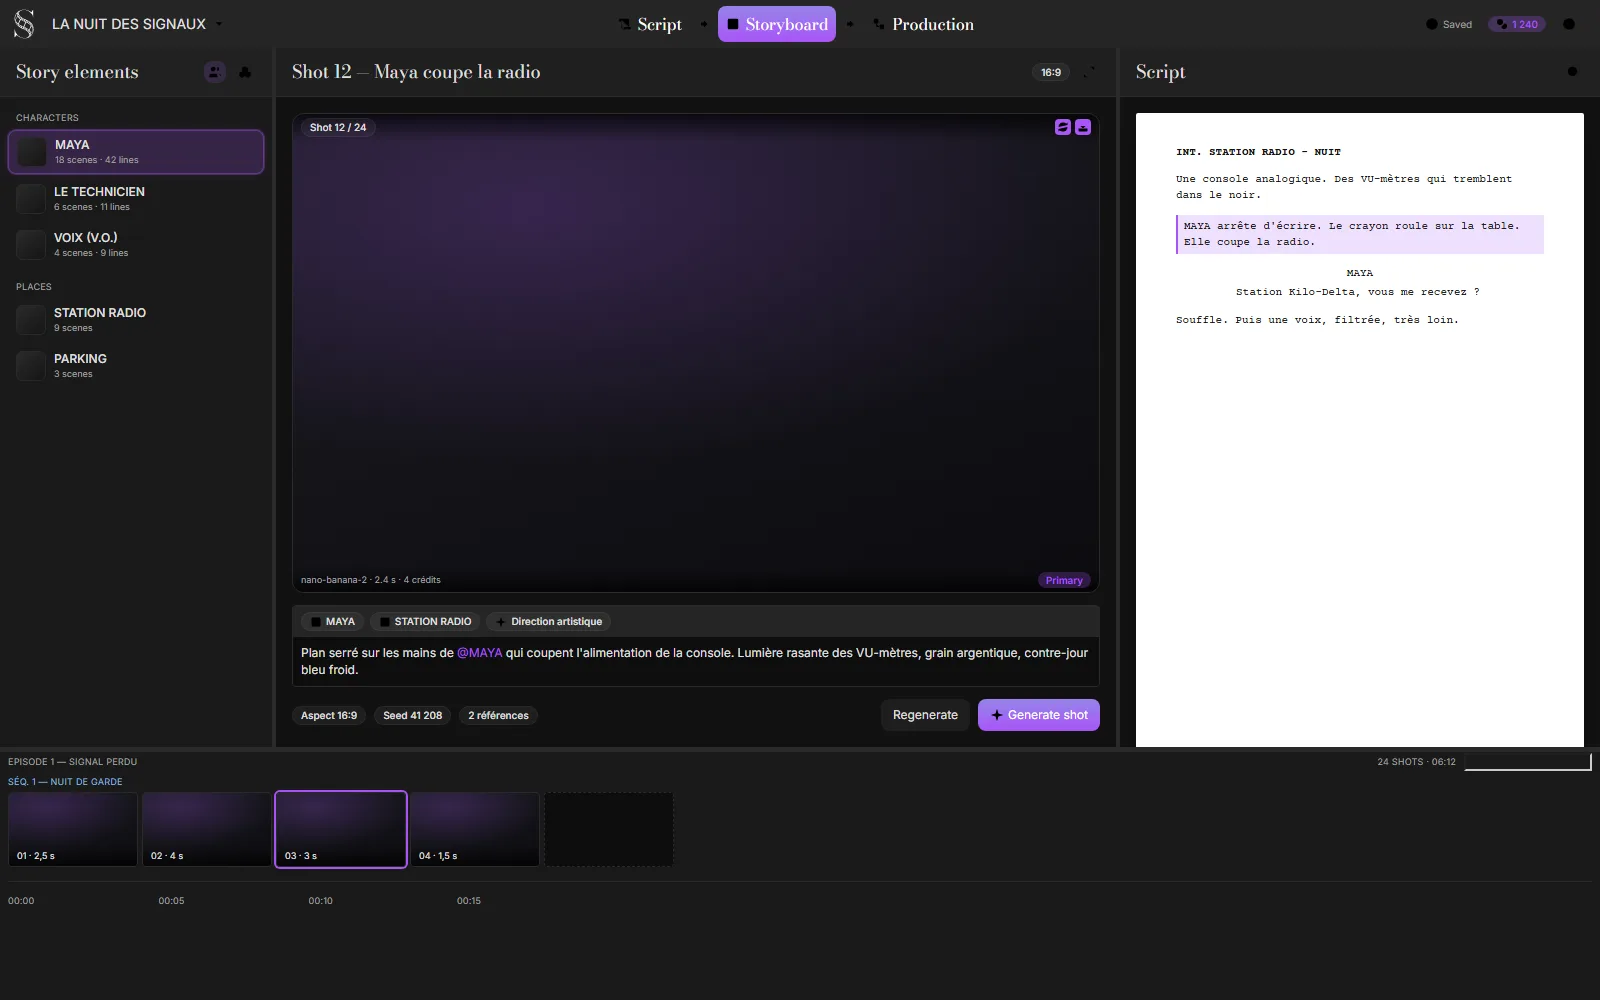
根据ScreenWeaver设计套件重构的Storyboard标签页界面。角色和地点位于左侧,每个镜头提示词按名称引用它们,底部的序列器记录各镜头时长。
第3步:生成16:9分镜
现在镜头表里的每个镜头都要得到一帧画面。条漫镜头的提示词有固定结构:
[景别], [按名称引用的角色], [格间留白中的动作],
[地点参考], [风格参考], 16:9
这个顺序是刻意的。景别放在最前,因为它是模型最常忽略的东西。角色按名称引用,工具才会挂上设定表。动作要写成正在发生的事,而不是画格里画了什么,因为画格展示的是凝固的瞬间,而你要的是读起来像在运动的画面。
重新构图是条漫特有的环节。竖向画格放不进宽银幕画面,所以每个镜头你都要在四种处理中选一种:
| 重新构图 | 何时使用 | 代价 |
|---|---|---|
| 裁到脸部或动作 | 特写和反应镜头,大多数对白镜头 | 没有,画格已经构好图了 |
| 向两侧扩展 | 地点很重要的远景 | 模型会画出新的背景,检查它是否与地点参考一致 |
| 把高度变成运镜 | 高格:建筑、坠落、揭晓 | 一帧画面在制作中变成一次摇镜,要画出起始帧和结束帧 |
| 拆成两个镜头 | 有两个焦点的格,或带有前后的动作 | 多一个镜头,也就多一段视频和一份预算 |
条漫转分镜指南逐格举例讲解了这四种处理。对默认裁切显然正确的镜头,也就是大多数对白镜头,可以批量生成。动作镜头一个一个来。
screenweaver.ai上的AI分镜生成器页面,截图于2026年9月3日。所有账户都可以使用分镜生成,并附赠一份免费积分入门包。若要从一话页面而非剧本开始,请使用上面MCP一节介绍的导入方式。
Try it free
Try Screenweaver for free on your script
It is free. Import your existing project, get a clearer view of your outline, and regain control of your story structure in minutes.
Start Free第4步:动作,一个镜头一个镜头来
每一帧分镜通过图生视频变成一段片段。画面是首帧,提示词描述什么在动,模型返回三到十秒。
适用于当前所有模型的规则:
- 每段片段只有一个动作。 “她转身,身后的门打开了”是两段片段,否则就是碰运气。
- 只用小幅运镜。 缓推、漂移、轻微上下摇。甩镜和环绕镜头出来都是错的。
- 中景以内的脸比远景更稳。 远景里脸占的像素更少,偏离设定更快。
- 对白片段要短。 生成角色说话的四到五秒,切到听者,再切回来。日式动画也是这么做的,这能掩盖模型最弱的地方:长时间持续的表演。
- 打斗要逐帧画分镜。 五格的打斗是八到十二段各只有一个动作的片段,编排交给剪辑。
模型默认会出错的一点是帧率。日式动画每张画面停留两到三帧,所以一段以24 fps顺滑播放的生成片段,在你抽帧之前看起来都像描摹实拍。AI动画制作流程指南讲解了每个镜头在哪里设置它。
各个模型对参考的遵循程度和能撑住的时长都不一样。与其列出到冬天就会过时的版本号,不如使用AI视频模型选择器,它会根据各模型的公开页面持续更新。ScreenWeaver的Production标签页可以从同一份分镜调用多个模型,一个镜头在某个模型上失败了,可以换另一个模型重试,而不必重写提示词。
平均每个镜头按三次生成来做预算。成本拆解说明了为什么这个倍数决定了账单。
在 ScreenWeaver 中
把一格漫画变成动画镜头
你自己的漫画格作为参考图输入,图像节点把它重绘成宽银幕动画画面,再由视频节点让它动起来。点击节点即可查看设置。
点击节点查看设置,拖动可移动位置。


第5步:配音、声音和剪辑
对白气泡变成台词。每句台词都有一个声音、一个时长和一条表演备注,这个时长还要回填到分镜里,因为一个一秒就能读完的气泡,说出来可能要三秒。这正是动画公司路线要花上几个月的循环:摄影表。
实际的顺序:
- 先录制或生成配音,再生成视频片段,这样你才知道时长。
- 每个对白镜头的时长设为台词长度加一拍。
- 按这些时长生成片段。
- 剪辑,然后加上音乐和音效。条漫里的拟声词就归入音效;漫画改编指南讲解了它们如何转换。
一支60秒的试播样片大约是15到20个镜头、40到60次生成、十来句台词和一个下午的剪辑。如果你想看去掉条漫特性的通用版本,请看AI视频的分镜优先工作流程。
这套方法在哪里会失灵
- 人群和背景角色。它们没有参考,所以会漂移。让他们在焦外或画外。
- 手里拿着东西的手。仍然是所有模型最弱的地方。分镜时绕开它。
- 长时间连续动作。一段片段超过八秒就会漂移。多切几刀。
- 画面里的文字。招牌、手机屏幕、信件。生成时留空,剪辑时再加文字。
- 作者本人的线条。成品会是那个风格,却不是那只手画的。熟悉作品的读者会看出来。这是否要紧,取决于另一个选项是不是根本没有动画。
也不是每部条漫都适合做成日式动画。设计圆润简洁的搞笑条漫或日常喜剧,做成平涂色彩、挤压拉伸的美式卡通,往往比赛璐璐风格的正剧效果更好。AI卡通制作方法讲解了这种风格,它建立在一张从第一个镜头到最后一个镜头都能稳住角色的设定稿之上。
如果目标是竖屏连载发布而不是16:9试播样片,短剧制作流程讲解了9:16单集格式、付费卡点集和悬念表。
发布之前:质量检查和版权核对
在剪好的成片和公开发布之间,还有两道检查。
质量检查。 把一个场景中所有通过的画面放进一个网格,与角色、地点和风格参考对照:脸型、头发、服装细节、比例、配色、背景。镜头与镜头之间看不出的漂移,放在十二个镜头里就一目了然,而作品的读者会最先看到。从选定基准话到逐镜头检查清单的完整流程,见动画中保持条漫角色一致。
版权核对。 改编你自己创作的作品,或你持有改编权的作品,并取得每一位合著者的书面同意。平台合约、配音和音乐各自都附带权利。条漫改编权里有核对清单,ScreenWeaver的条款写明了它对你的输出主张什么权利:什么都不主张。
保留镜头表、重新生成记录和项目历史。它们是你的制作日志,是你作者身份的证据,如果你要公开制作花絮,也是素材。
FAQ
AI能自动把条漫转换成动画吗?
不能一步到位,任何声称能做到的,产出的都只是带着镜头漂移的幻灯片。AI擅长的是两个最昂贵的部分:基于你自己的画格让角色和风格保持设定,以及从分镜画面生成动作。镜头拆解、节奏和剪辑仍然由你来做。
把条漫做成动画需要剧本吗?
做试播样片不需要。根据画格整理的镜头表就够了:场景、镜头、来源画格、景别、什么在动、对白。做一整季的话,多花一天写剧本是值得的,因为它能给你时长估算和可以检索的大纲。ScreenWeaver两者都接受,也能直接接收一话的页面:通过MCP或应用内助手导入,画格就会变成一份供你修改的镜头表。
ScreenWeaver能导入我的条漫单话吗?
能。通过ScreenWeaver MCP(在Claude、ChatGPT、Claude Code、Cursor或VS Code中)以PDF或图片形式发送页面,或者在应用内的助手中附上它们。画格会被自动裁出,助手起草角色阵容和镜头,每个画格成为对应画面的参考。没有单独的导入按钮:你提出要求,助手调用工具。之后由你在应用中生成画面和视频。
画格检测要消耗积分吗?
每页约1积分,1积分相当于半美分。超过20页时,导入会暂停,显示预估费用并等待你确认,已经检测过的页面不会重复收费。通过MCP,不开检测导入页面、按助手自己画的框裁切画格、写镜头,都不消耗积分。在应用中,助手自身的回复按积分计费,每次请求最多200积分。
如何让角色在AI生成的镜头之间保持一致?
用条漫本身建立参考:正脸、四分之三侧脸和侧脸,默认服装的全身像,以及关键表情,全部从画格中截取。把它们挂到一个有名字的角色上,并在每个镜头提示词中引用这个名字。在最需要一致性的地方,把镜头控制在中景或更近。
条漫动画应该用什么画幅?
要发到YouTube或流媒体平台的,用16:9,这意味着每个竖向画格都要重新构图。9:16适合短视频,以及你的读者已经在的平台,重新构图的工作量也小得多。很多创作者用16:9画分镜,再从同一批镜头里裁出一个9:16版本。
用AI把一话条漫做成动画需要多久?
用一话里最精彩的场景做一支60秒样片:两到五天,大部分时间花在重试和剪辑上。完整一话50到70个镜头:一个人一到三周,取决于动作镜头有多少。对白场景进展快,打斗场景则不然。
我在ScreenWeaver中生成的画面和片段归谁所有?
根据其条款,ScreenWeaver不主张对你的输出的所有权,你的输入也归你所有。它不承诺AI输出在每个国家都具有原创性、排他性或受版权保护,这取决于其中的人类创作成分。你的画格、角色、剧本和剪辑属于你。详情见条漫改编权指南。
动画看起来会和我的画风一模一样吗?
会是你的风格,但不是你的手笔。有好的风格参考,配色、线条粗细和明暗处理都能保持得很好。作者线条的确切质感留不下来,动作也会让观感稍有变化。熟悉作品的读者会注意到,新观众则不会。
Final Step
Build your next script with Screenweaver
Move from ideas to production-ready pages faster with timeline-native writing and AI-assisted story flow.
Try Screenweaver