AI 人物一致性表
构建那段你要粘进每个片段的一致性提示词
把你的角色描述一次,这个工具就会把它拼成四种格式的一致性提示词:一段致密的散文块、一份紧凑的 JSON,以及为 Veo、Sora、Kling 和 Runway 排好顺序的版本。为那些主角每换一个片段就换一张脸的 AI 电影人而造。
文生视频模型在两次生成之间没有记忆,所以同一个角色要想保持同一个样子,唯一的办法是每一次都用同样的方式描述他。解法是一段一致性描述块:精确的服装颜色、一个辨识度高的细节、一条锁死的光线与调色说明,逐字粘在每条提示词的最前面。具体胜过冗长:「铁锈橙灯芯绒夹克」立得住,「时髦的夹克」就会飘。
全部在你的浏览器里运行。保存的角色存在浏览器的本地存储里,从不会被发送到任何服务器。
知道多少填多少。留空的字段会被跳过,但精确的颜色和一个辨识度高的细节,最能防止形象漂移。
你的一致性描述块
在上面至少填一个字段,就能生成你的人物描述块。
已保存的角色
只保存在你的浏览器里。每个角色建一块,然后在群戏时把整组复制出来。
还没有保存的角色。在上面给一个角色起名并点保存角色,就能开始建立你的演员表。
工作原理
这张表把你填的字段拼成几种确定性的描述块:一段在任何模型上都能用的致密散文,一个供结构化流程使用的紧凑 JSON 对象,以及三个遵循各家提示指引的模型专属版本(Veo 需要一句以风格收尾的主体描述句,Sora 对叙述性散文反应更好,Kling 和 Runway 对逗号分隔的标签解析得最稳)。留空的字段会被干净地跳过,所以填了一半的表也能产出可用的描述块。保存会把角色存进浏览器的本地存储,下次打开时你就能把演员表重新建起来。
怎么让同一个角色跨 AI 视频片段保持一致
人物漂移是多片段 AI 电影的头号杀手。一个主角的夹克在两个镜头之间换了颜色,比任何渲染瑕疵都更快地把故事撕破,因为观众先追的是脸和衣服。每次生成都从零开始,所以一致性不是模型的某个设置,而是提示词的纪律:同样的描述,完整地重复,出现在每一条提示词里。
具体胜过冗长。一段 40 词、写明精确服装颜色(「铁锈橙灯芯绒夹克,里面白色 T 恤」)和一个辨识细节(「左眉上一道细疤」)的描述块,比 200 词的人物小传更管用,因为模型给具体的视觉词的权重高于背景故事。这就是一致性表背后的逻辑:它把描述压到真正控制像素的那些词上,无论你是要在 Veo 里保住同一个角色,还是要在 Sora 的整段序列里锁死一致性。
永远别写「和刚才同一个女人」。对模型来说没有「刚才」,每一条提示词就是它的整个世界。每次都把完整的描述块重新粘上;群戏时,给每个角色自己的描述块,再加一条共用的光线与调色说明,让整组人看起来像是同一个剧组拍的。把这个结果当成你的 AI 人物圣经,它在片段之间做的事,正是服装部门在真实片场做的事。
锁定演员表之后,用我们的 免费 AI 视频提示词生成器 把每个镜头提示词的其余部分建起来,并把人物描述块粘在它生成的内容上方。
适合谁
- 做 AI 短片的人 在生成第一个片段之前,就给每个主角建好一份人物参考提示词模板,剪起来才接得上。
- 做剧集和分集内容的人 把整组演员存在浏览器里,下一集时再把同样的描述块原样载入,哪怕已经过去几个月。
- 品牌和社交团队 一次锁定吉祥物或代言人的形象,然后把同一段描述块交给每个剪辑的人,无论他们用哪个模型生成。
从剧本出发,直接得到分镜。
ScreenWeaver 把你的剧本拆成镜头,并据此生成分镜。景别、角度、运镜和时长都由你掌控。角色在镜头之间保持一致。
- 0 美元,永不过期
- 导出 PDF 和 Final Draft
- Mac、Windows、Linux、iPad
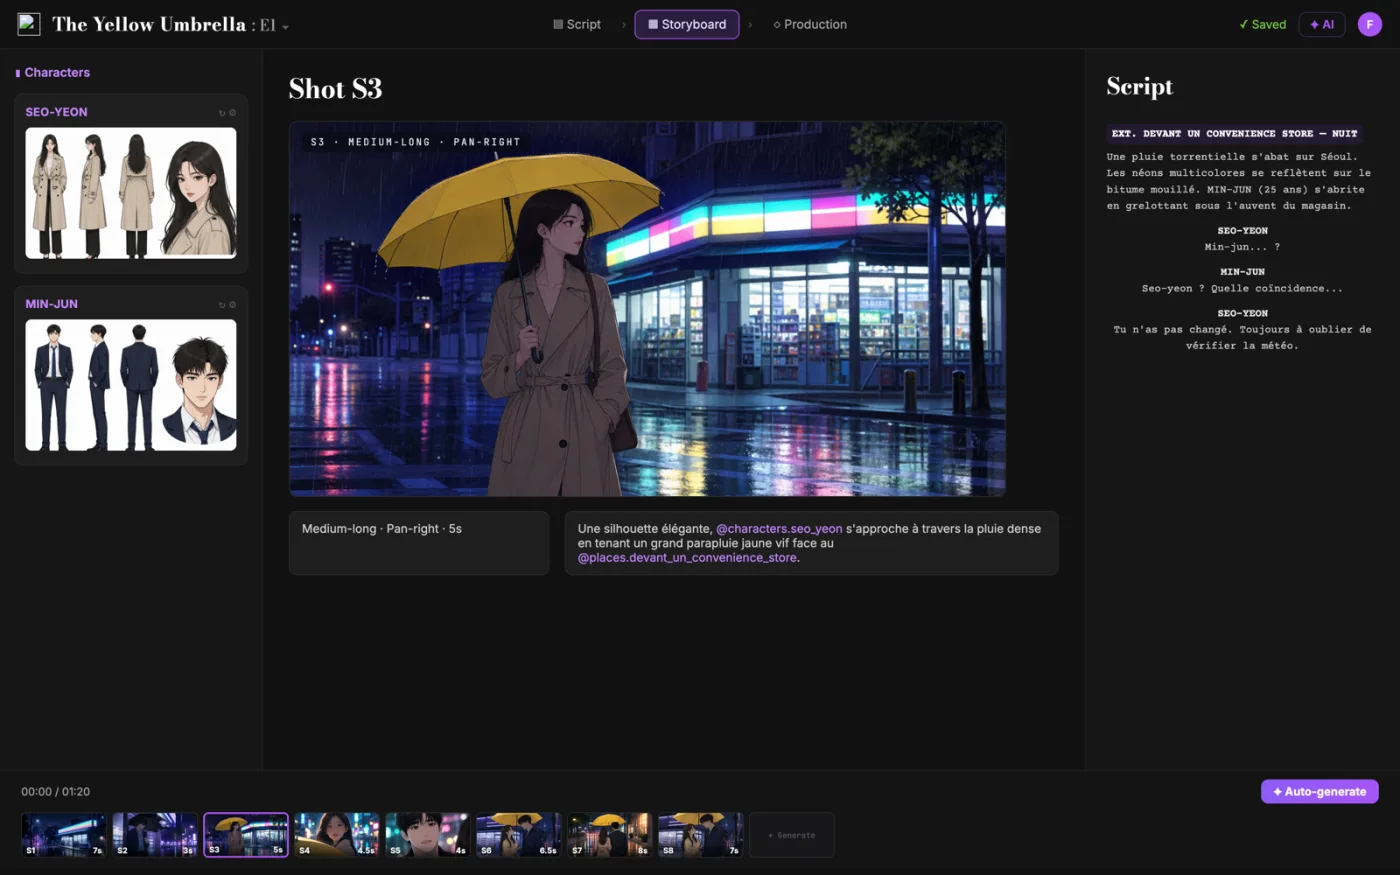
AI 人物一致性表:完整指南
它把你填的人物字段拼成一段密实的散文、一个紧凑的 JSON 块,以及 Veo、Sora 和 Kling/Runway 的三种版本,顺序按各家模型的提示词建议来排,空字段干净地跳过。
这类工作的核心问题很清楚:文生视频模型在两次生成之间没有记忆,人物因此会漂移(换了脸、换了外套、换了发型),除非每条提示词都重复同一段具体描述。不解决,它就会在后面的环节制造摩擦,让决策变慢。实际要达到的是一段可复用的一致性描述块,有散文版、JSON 版和分模型版本,还有一份保存好的角色表,可以重新载入并整套复制。
需要记住的限制:一段文字能减少漂移,但消不掉:它控制不了随机种子和参考图,脸仍可能有出入。你的模型如果支持参考帧,就搭配着用。
进阶用法:有经验的团队把这张表当人物圣经用:每个角色一段保存好的描述,全体共用一行光线和调色,再把整组描述贴在每一场戏的提示词上方,这样多人同框的镜头才立得住。
一步步怎么做
- 按摄影机看得见的东西来填:服装的准确颜色、头发的形状、一个辨识度高的细节、走路的方式、光线。
- 复制与你的模型对应的版本:Veo 的整句、Sora 的叙述,或 Kling 和 Runway 的标签串。
- 把这段原样贴在每条提示词的开头,放在这条镜头自己的动作和运镜之前。
- 把每个角色保存下来,用「复制全部角色」把整组贴进多人同框的场次提示词里。
按角色分的使用场景
- AI 短片创作者:开拍前先锁定主角的样子,剪进去的每一条素材才是同一个人。
- 剧集作者:下一集直接载入保存好的角色表,几周的生成之间也能守住连贯。
- 品牌团队:发一份统一的代言人描述块,所有人生成的都是同一个人物。
常见的坑
- 写「和刚才那个人物一样」,模型没有记忆,解不了这句话。
- 服装写得含糊(「一件时髦外套」),而不是模型能复现的准确颜色和单品。
- 在两条素材之间稍微改一改描述,把这段描述本来要防的漂移又请了回来。
行业里的做法
- 给每个人物正好一个显眼的辨识细节;它会成为你每条素材都去核对的那个锚点。
- 全体角色共用一行光线和调色,多人同框才像是同一次拍出来的。
- 按项目管理版本,不要按素材:外形要改就改一次,然后整场重新生成。
把这个工具的输出当成决策的辅助,而不是写作本身的替代。一个好剧本被记住,靠的是具体的选择、准确的情绪,以及戏剧动作的清晰。工具的作用是把噪音去掉,让你的精力落到真正要紧的地方:人物、冲突、升级和兑现。每过一轮就回看一次结果,把接受的改动记下来,你的工作方式会一稿比一稿更快、更可预期。这种稳定正是专业合作者看重的东西:意外更少,理由更清楚,剧本朝着有意识的方向长。
延伸问答
什么是 AI 人物一致性提示词?
一段固定文字,用准确的措辞描述人物的脸、头发、服装和风格,贴在每条视频提示词的开头。逐字重复它,目前仍是让人物在多条素材之间保持可辨认的最可靠办法。
Sora 能在多次生成之间保持人物一致吗?
它自己做不到:每次生成都是独立的。Sora 对叙述性的散文反应最好,所以这张表的 Sora 版本把人物写成一段连贯的描述,放进每条提示词里,也可以再配一张参考图。
用于 AI 生成的人物表该写什么?
姓名、年龄段、脸和体型、头发、带准确颜色的服装、一个辨识细节、动作质感、光线和调色、视觉风格。这些是模型能翻译成像素的字段;人物前史是多余的重量。
为什么要用 JSON 写人物描述?
有些流程和管线会用模板批量拼提示词,也有少数模型对结构化输入解析得不错。JSON 块带的字段和散文版一样,用 snake_case 键名,空字段会略去。
Kling 和 Runway 的版本跟 Veo 的有什么不同?
Kling 和 Runway 对逗号分隔的标签串解析最稳,所以那一版把你的字段压成标签,再加一句一致性锚点。Veo 的建议更偏向一整句主体描述、以风格收尾,它那一版就是按这个顺序排的。
保存的人物存在哪里?
只存在你浏览器的本地存储里。同一台设备、同一个浏览器刷新后还在,永远不会上传,清掉站点数据就没了。长期项目请把这些描述另存一份。
常见问题
把完全相同的人物描述粘在每条提示词的最前面,主体在前、风格收尾,也就是这里的 Veo 版本生成的那种写法。如果 Veo 支持参考图,就把这段描述块和同一张参考帧搭配使用,多一重视觉锚点。
因为模型在两次生成之间没有记忆,任何没被指定的属性它都会重新猜一遍。你留模糊的每一个字段(头发长度、夹克颜色、年龄),都是模型会重新掷一次骰子的字段。一段完整并且重复出现的描述块,能把这种随机性去掉。
不该。背景故事的词对像素几乎没有影响。把词花在摄影机看得见的东西上:精确的服装颜色、头发形状、一个辨识细节、动作的质感,以及光线调色。短而具体,胜过长而文艺。
给每个角色各自保存一块,然后用「复制全部角色」把整组粘出来。所有人共用一条光线和风格说明,这样整组人看起来才像是同一个剧组拍的。
不会。描述块完全在你的浏览器里拼装,保存的角色存在浏览器的本地存储里。没有任何内容被发送到服务器,清除浏览器数据就会把它们删掉。
Related tools
场景切片规划器
把一场戏切成符合你模型时长上限的 AI 视频片段。
AI 视频提示词生成器
为 Veo、Sora、Runway 和 Kling 构建电影感提示词。
人物弧线工作表
梳理想要、需要、缺陷、创伤和最终抉择。
运镜提示词
带动画演示的运镜库,附可复制的 AI 视频提示词。
You can also browse the full library on /tools.
Core blog guides
- Idea → first draft (process hub)
- Screenplay format guide 2026
- Hidden costs of “free” software
- Affordable software & TCO
- Revision passes (structure → dialogue)
影视技法
值得了解的电影技法
每一种都附有短片、剧本片段和分镜表中的一行写法。