先说结论:AI 分镜里人物保持一致,靠的是每个角色一张固定的参考设定图。它根据文字描述生成一次,然后附在这个角色出现的每一格分镜上。提示词写得更长解决不了问题,反复重新生成碰运气也不行。下面分七步讲这个方法,以及它会在哪些地方失效。
这里用的工具是 ScreenWeaver 的与剧本联动的分镜工作区,设定图是内置对象,而不是你自己管理的一文件夹图片。这个原则适用于任何支持参考图的分镜生成工具。如果你还没完整跑过一遍分镜,从剧本生成 AI 分镜的完整流程讲了整条管线;本文只讲大家最常跳过的那一步。
分镜为什么会“跑脸”
每一格都是一次全新的生成。模型画第 5 格时并不记得第 4 格。它对你的主角了解多少,完全取决于你这一次给了它什么。
给它一段文字,你给的是一个范围。“一个五十多岁、穿深色大衣的高个女人”能对上成千上万个女人和几百种大衣,每一格都从中抽一个。脸会漂移,大衣的版型、长度和颜色都会变。到了第 9 场的全景,看分镜的剧组会问:第二个女人是谁?
给它一张图,你给的是一个点:一副身形、一条发际线、一件扣子数量都确定的大衣,是照着复制,而不是重新理解。参考设定图方法就是这一招:把身份从提示词里拿出来,放进一张图,并且确保这张图每一次都在。
动画行业一百年前就用角色设定稿(model sheet)解决了这个问题:一张从多个角度画角色的图,钉在每张画桌上方,让五十双手画出同一个人。分镜参考设定图就是同一份文件,只不过是生成的,不是手画的。
第 1 步:决定谁需要设定图
不是每个人都需要。一张设定图要花一次生成和几分钟写作,而只出现在一格里的角色不会跑脸,因为没有可以偏离的基准。
| 角色 | 要不要设定图 | 原因 |
|---|---|---|
| 主角,出现在大部分场次 | 要,最先做 | 每一格都依赖它 |
| 配角,三场以上 | 要 | 到第二场就能看出漂移 |
| 两场戏的小角色,但外形辨识度高(制服、特效妆、特别的发型) | 要 | 剧组会注意的正是这个外形 |
| 只出现一场、但有好几格的路人 | 通常要 | 正反打时,场内一致性同样重要 |
| 只有一格,没有台词 | 不要 | 没有需要保持一致的东西 |
地点和道具也照此筛选。反复出现的地点和主角一样需要设定图;推动剧情的道具,如果会不止一次出现特写,也需要一张。在 ScreenWeaver 里,Storyboard 标签页左侧的元素面板已经列出了从剧本中提取的人物、地点和道具,所以筛选只需过一遍。
第 2 步:写出生成设定图所依据的描述
后面的一切都继承自这一步,而大多数人只在这上面花九十秒。
在 ScreenWeaver 里,每个元素都有一个情绪板,上面钉着一段描述文字。参考设定图的提示词读的就是这段文字。角色的其他任何信息都到不了设定图的生成:台词不会,动作描写不会,你脑子里的选角想法也不会。如果这段文字是空的,工具会在生成前提醒你,因为只靠名字做出的设定图,就是用默认值做出的设定图。
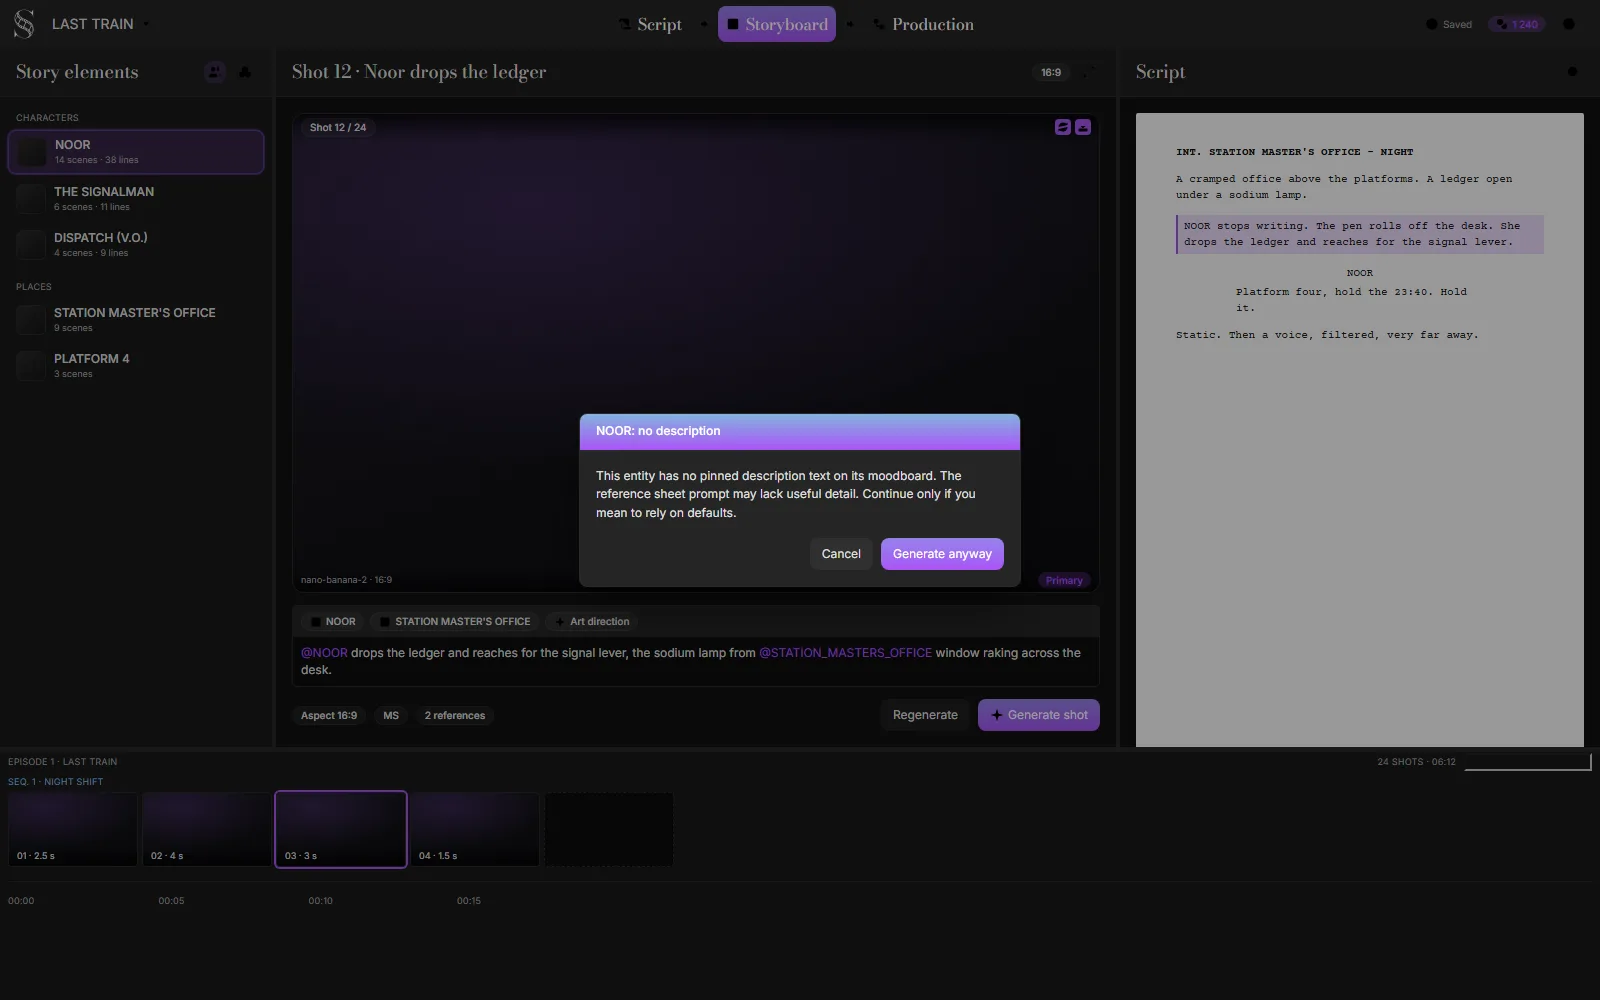
Storyboard 标签页中的“缺少描述”提示,用 ScreenWeaver 界面组件和产品原文还原,2026 年 9 月。
把这个提示当真。取消,写好描述,再生成。
描述里写的是外在事实,不是性格刻画。模型画不出“受伤的自尊”,而“中年”它每次都会画得不一样。用三四句话,写出服装设计和选角导演各自需要知道的东西。先写身体:性别、年龄段、身高、能说清的体型。然后是头部:头发的长度、颜色和发型,肤色,胡子,眼镜。接着是每件衣服的颜色和材质、鞋子,以及一个在全景里也能一眼看到的特征。最后写她什么都不做时怎么站。
本文一直使用的角色 Noor,她的描述是:
Noor,女,五十五岁上下,个子高,体格壮实,肩宽。灰色短寸头,深棕色皮肤,不戴眼镜。及膝的深蓝色羊毛铁路制服大衣,黄铜纽扣,最下面两颗缺失,里面是灰色圆领毛衣。红围巾在喉咙处打一个结。黑色系带靴。脖子上用链子挂着老花镜。站得笔直,双手插在大衣口袋里。
这段描述里的每个名词,都是生成工具能复制、审核的人能核对的东西。会失败的写法:
| 常见写法 | 为什么会漂移 | 应该怎么写 |
|---|---|---|
| “时髦,利落” | 风格是一个范围,不是一件衣服 | 写出具体的衣服和颜色 |
| “中年” | 在多数模型里横跨 35 到 60 岁 | “五十五岁上下,灰色短寸头” |
| “运动型身材” | 可能是游泳运动员,也可能是摔跤手 | “个子高,肩宽,小臂粗壮” |
| “眼神疲惫,背负着悲伤” | 情绪属于这一格的动作描述,不属于设定图 | 删掉 |
| “长得像年轻时的阿尔·帕西诺” | 像某个真人既不可靠,也有肖像权问题 | 写出你真正想要的五官特征 |
| “穿着一件外套” | 版型、长度和颜色每一格都会变 | “及膝深蓝羊毛大衣,黄铜纽扣” |
如果从零开始写很难,AI 角色一致性设定表会带你填同样的字段(年龄段、脸和体型、头发、准确的服装、一个辨识特征),并组装成一段可以贴到情绪板上的描述。它原本是为视频提示词做的,但字段和分镜设定图需要的完全一样。
一段描述只对应一套服装。如果 Noor 在第一幕和第二幕穿大衣,第三幕穿病号服,那就是两张设定图,第 6 步会讲怎么处理。
第 3 步:生成设定图,像读角色设定稿一样检查它
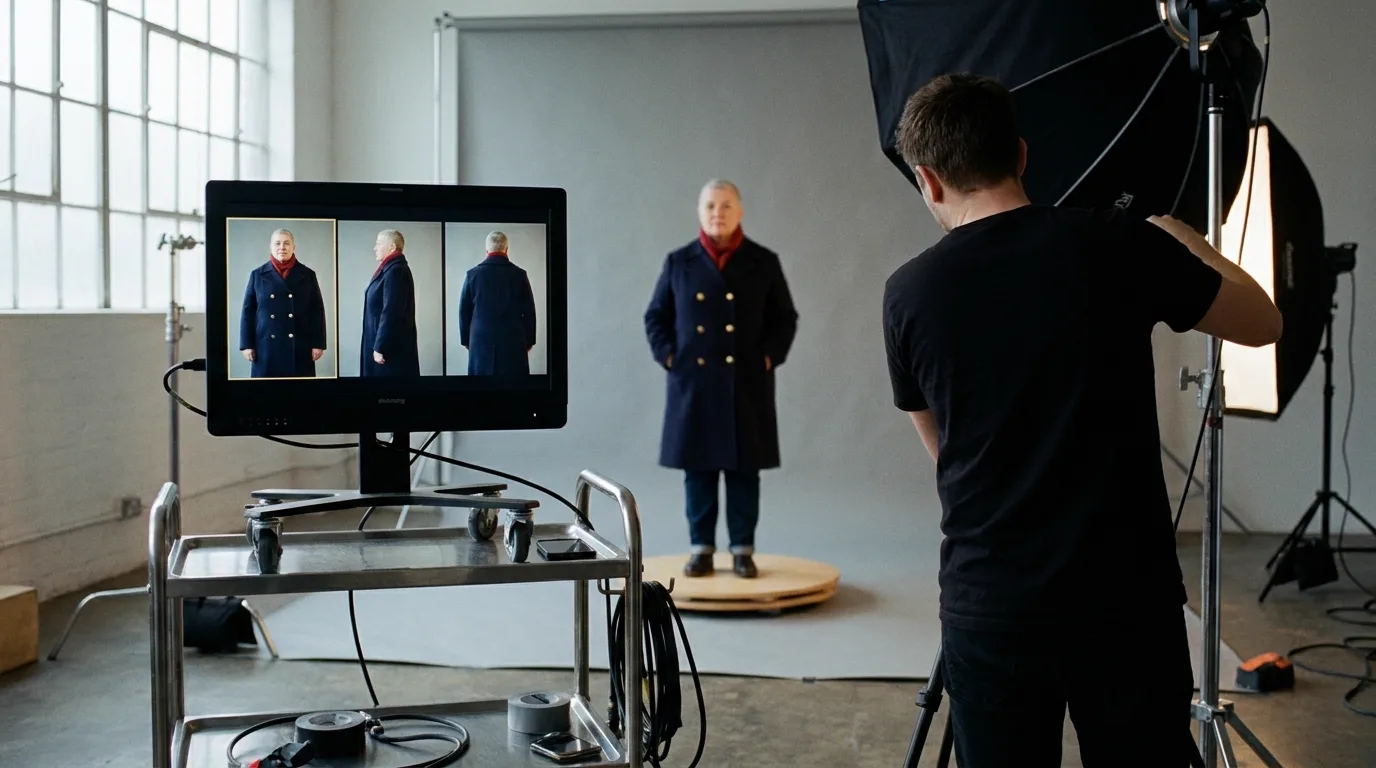
在元素面板里生成参考设定图。对于角色,ScreenWeaver 的设定图提示词要求在同一张图上以相同比例、相同地平线画出四个全身视角(正面、四分之三侧、正侧面、背面),另加一个中性四分之三角度的头部特写,姿势是中性站姿。设定图刻意采用白底上的朴素预演风格:简单的形体,克制的颜色,没有文字,没有标签。
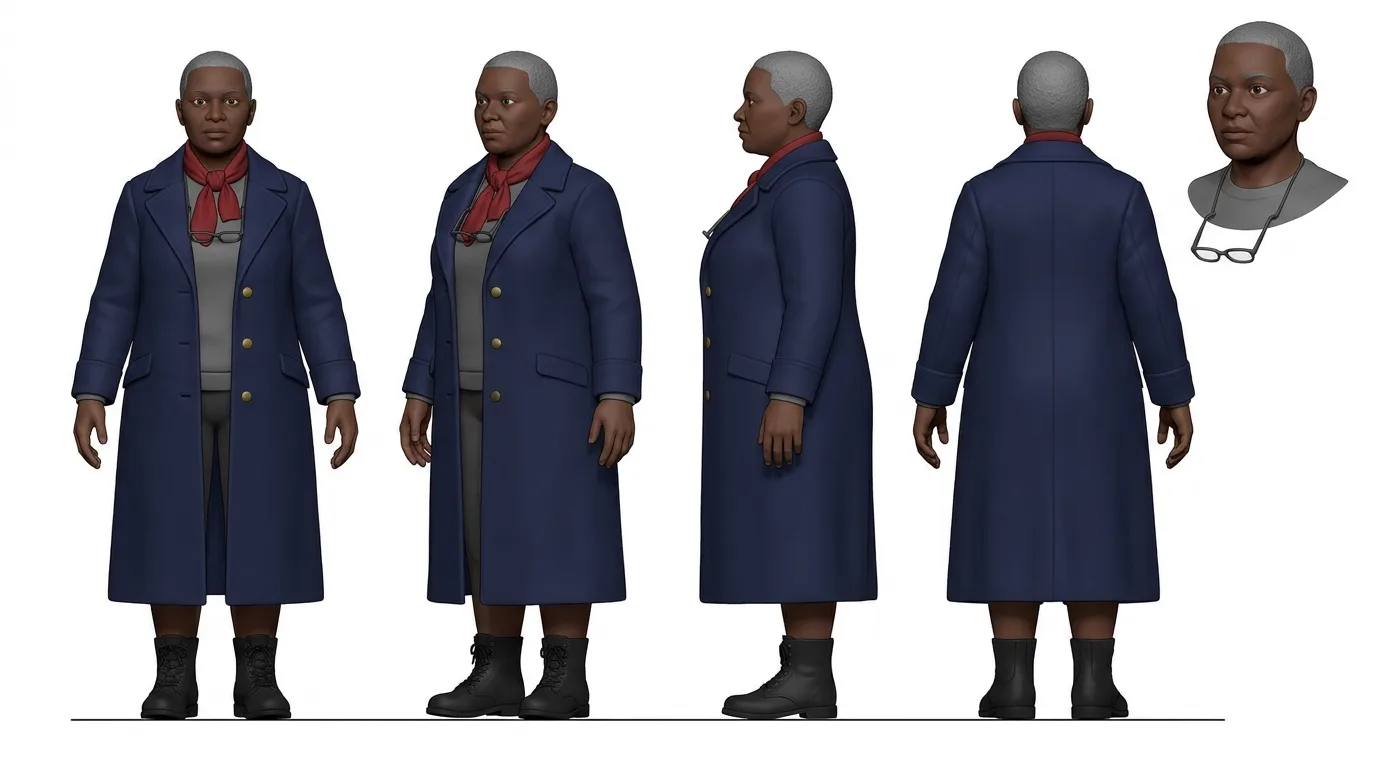
为本文生成的 NOOR 参考设定图,依据上面的描述,使用与 ScreenWeaver 角色设定图相同的四视角提示词模板和模型,2026 年 9 月。
拿它和描述对照,马上能看出两点。模板的中性站姿压过了“双手插在大衣口袋里”,这没问题,因为站姿属于分镜那一格,设定图只需要提供身体。另外,大衣上有三颗纽扣,下面是空着的羊毛面料,这是对“最下面两颗缺失”的一种理解;如果缺失的纽扣在画面里很重要,就值得再生成一次。检查要的就是这种程度的细心。
朴素的风格是刻意的。一张光影浓郁的写实肖像,会被分镜生成器既当作要复制的人,也当作要模仿的画风,于是每一格都会继承那种光线。白底上一个平面的预演人物只承载身份,几乎不带别的东西,这正是参考图应该承载的。
现在,在接受之前,把描述放在旁边,仔细读这张设定图:
- 四个视角彼此一致吗? 每个角度身高相同、体型相同、头发相同。如果背面的头发比正面长,设定图就会教给分镜生成器两个人。
- 服装里的每个名词都在吗? 数纽扣,看围巾,找眼镜链。设定图上缺的细节,每一格都会缺,而且你没法用提示词补回来。
- 缩略图大小时轮廓还认得出吗? 眯起眼睛看。如果 Noor 作为一个形状认不出来,在全景里也认不出来。
- 有没有描述里没有的东西? 凭空多出的配饰、帽子、包。重新生成。模型在这里加的任何东西,都会成为整部分镜的设定。
只要有一项不过关,就不要试图在分镜格里修。改描述,重新生成设定图,再检查。重新生成两次设定图,比重新生成一整场戏便宜。
画风离开预演越远,这份清单越重要。简洁、风格化的造型最脆弱:帽子或耳朵一变,观众就会看成另一个角色。我们的 AI 动画短片方法展示了一张四视角、四表情的角色设定稿如何让一只快递狐狸贯穿每个镜头;AI 制作 3D 动画指南则在圆润、带光照的角色上做了同样的环绕视图,在那里,一只手套从橡胶变成皮革,比脸更早打破幻觉。
第 4 步:角色在画面里的每一格都引用设定图
设定图在被某一格使用之前没有任何作用。在 ScreenWeaver 里,分镜格的动作描述就是提示词,而且只有一种语法:@ 引用一个元素,也就是把这个元素的设定图作为参考附到生成上。输入 @,选 Noor,设定图就跟着这一格走。
这时分镜格的提示词会带上一条严格指令:完全匹配被引用角色的脸型、比例、头发、服装、轮廓和姿态,不重新设计,不换装,不增减配饰。这条指令不用你写,引用这个名字就会生效。
引用的规则比直觉更窄。只有 Noor 在画框里时才引用她。如果只是有人提到她,或她站在同一个房间的画外,或这个镜头是她看向别人的主观镜头,就不要引用。引用一个不在画面里的角色,等于邀请模型把她放进去。
还有,别在动作描述里再描写她一遍。动作描述是写这一拍发生了什么:Noor 丢下账本,伸手去扳道岔拉杆。 而不是:Noor,一个五十多岁、穿深蓝大衣的高个女人,丢下账本。 第二种写法给了模型两个标准答案,一张图和一段文字,等于允许它取平均。身份放在设定图里,动作放在文字里。直接给视频模型写提示词时也是同样的分工,详见围绕参考图写人物一致性提示词。
引用了尚不存在的设定图的镜头,会被标记为“受阻”,自动生成会拒绝渲染它,直到设定图出现。这个拦截是在帮你,因为你本来会得到的,正是那一格跑脸的画面。
Try it free
Try ScreenWeaver for free on your script
It is free. Import your existing project, get a clearer view of your outline, and regain control of your story structure in minutes.
Start Free第 5 步:做分镜之前,先跑三格测试
在批量生成之前、在第一场之前,专门生成三格 Noor,按这个顺序:
| 格 | 景别 | 测试什么 |
|---|---|---|
| 1 | 特写,正对镜头 | 脸和头发。最简单的测试,也是大多数人止步的地方。 |
| 2 | 中景,四分之三侧,手上在做事 | 真实动作下的服装细节和体型。 |
| 3 | 全景,背影,正在走远 | 轮廓、大衣长度、站姿、后脑的头发。没有脸可以骗过你。 |
第 3 格才是关键。有一张好的设定图,如今脸大多能稳住。分镜依然会崩的地方是轮廓和服装,而背影全景是唯一一格没有别的东西分散你注意力的画面。如果 Noor 的大衣变成了齐腰,或者肩膀变窄了,你只花了三格的代价就发现了,而不是三十格。
每一格测试都拿设定图来判断,而不是拿上一格测试来比。测试失败时,问题几乎从来不在这一格本身:要么描述太单薄,要么设定图的视角互相矛盾,要么漏了引用。退回一步,修好,再测一次。三格都通过之后,才打开自动生成,让它跑完剩下的部分。
第 6 步:处理剧情本身需要的变化
角色会按剧情变化:淋湿、流血、变老、换衣服。提前规划,这个方法就撑得住;临场应付,它就会崩。
换装就是第二张设定图。 新建一个元素,起一个没人会弄混的名字(NOOR(病号服)、NOOR(婚礼)),描述里身体和头部的段落一字不改地重复,只替换服装段落,然后每场引用对应的那一张。正是重复的身体段落,让她在两张设定图之间保持是同一个人。
场内的变化写进动作描述和延续链。 Noor 在第 14 个镜头被淋透,整场戏都是湿的。在第 14 镜的动作描述里写“浑身湿透,头发贴在头上,大衣被雨水浸成深色”,然后用 Continues from 字段把第 15 到 19 镜指向第 14 镜。延续镜头的指令是保持上一格的服装、走位和光线,只推进动作,所以湿透的样子会延续下去,不需要新设定图。这场戏结束、她又干了以后,取消延续链,回到普通引用。
跨越漫长时间的衰老也是第二张设定图,身体段落要刻意重写,而不是照抄。二十年后是另一种轮廓。
不该做的是改原来的描述去反映新状态。你一改 Noor 所依据的设定图,之前用它生成的每一格就都过时了,而你不会记得是哪些。
第 7 步:锁定设定图
测试通过后,设定图就冻结了。有帮助的话,在元素名旁边写上日期。从这里开始,三条规则。
重新生成分镜格,不重新生成设定图。某一格跑脸了,先用同样的引用重新生成这一格。单格漂移大多只是运气不好,用相同输入再生成一次就能解决。
如果同样的漂移在多格里反复出现,原因在设定图,而修设定图等于把分镜重置。动手之前先接受这一点。重新生成设定图,意味着所有引用它的分镜格也要重新生成,否则分镜里会有两个 Noor,每个版本的设定图各一个。要么早做,要么不做。
设定图不是定画风的地方。客户想要更暗沉的分镜,那是分镜格层面的参数,不是一张更暗的设定图。设定图保持平面、朴素,这样画风改变时它依然有效。
常见失败,以及真正有效的修法
| 你看到的现象 | 真正原因 | 修法 |
|---|---|---|
| 每一格脸都不一样 | 没有设定图,或设定图来自一行字的描述 | 写好描述,重新生成设定图,再重新生成分镜格 |
| 脸稳住了,大衣长度或颜色在变 | 描述里没写服装,所以设定图这部分很模糊 | 在描述里补上颜色、材质和长度,重新生成设定图 |
| 同一场里出现两个版本的角色 | 分镜做到一半重新生成了设定图 | 重新生成所有引用它的格,或者退回旧设定图 |
| 角色出现在她不该在的格里 | 在只被提到或在画外的镜头里引用了她 | 去掉引用 |
| 该有她的全景里却没有她 | 没引用,或名字没解析 | 加上引用;名字未解析时分镜格会提示 |
| 角色样子对,但每格都僵硬、姿势一样 | 动作描述太单薄,模型退回设定图的中性站姿 | 写出关键瞬间的具体肢体动作 |
| 分镜格继承了你没要求的画风 | 设定图被重新生成成带风格、带光影或写实的样子 | 设定图保持默认的朴素风格 |
| 镜头被标为“受阻” | 分镜格引用了不存在的设定图 | 先生成缺失元素的设定图 |
设定图无法保证的事
参考设定图能让一个角色在一格又一格之间被认出是同一个人,用的是为规划服务的预演画风。它不会让她像某个特定演员,也不该去尝试。分镜存在的意义,是让剧组读懂调度、镜头覆盖和连戏;分镜镜头类型参考讲了每一格要传达什么,“像谁”不在清单上。
设定图也不会自己延续到成片画面。生成视频是另一条管线,有自己的参考资料、自己的画风,以及超过十个镜头后更难的一致性问题。到了那一步,AI 视频中的人物漂移会讲这个阶段。不过你在第 2 步写下的描述可以直接带过去,这也是第一次就把它写好的又一个理由。
还有,任何设定图都救不了一个还没想清楚角色是谁的剧本。如果你写不出四句话描述 Noor 长什么样,问题出在分镜的上游。
FAQ
要做出一致的 AI 分镜,一个角色需要几张参考图?
一张就够,前提是这张设定图以相同比例展示多个角度。ScreenWeaver 的角色设定图在一张图里给出正面、四分之三侧、侧面、背面以及头部特写。只有一张正面肖像是不够的,因为分镜生成器得自己编出背面和侧面,而每次编的都不一样。
为什么参考设定图用朴素风格,而不是我影片的画风?
为了让分镜生成器复制的是人,而不是光线。带风格的设定图会把它的氛围、配色和渲染方式推到每一个引用它的格里。就算分镜不朴素,设定图也要保持朴素。
引用设定图之后,还要在每格提示词里描写角色吗?
不用。引用设定图,动作描述只写动作。再描写一遍角色,等于给模型第二个标准答案去和图片取平均,而这个平均正是漂移的来源。例外是暂时性的状态(湿透、带血、戴着帽子),它们要写进那个镜头及其延续镜头的动作描述里。
角色中途换衣服怎么办?
新建第二个元素,做第二张设定图,身体和头部的描述一字不改,只改服装部分,然后哪一套在场就引用哪一张。不要改原来的描述,否则之前用它生成的每一格都会过时。
有一格画坏了,是重新生成这一格还是设定图?
先重新生成这一格,引用不变。一次失手很正常。如果同样的漂移出现在三格里,说明设定图或描述太单薄,修它就意味着重新生成所有引用它的格。所以三格测试要在批量生成之前做,而不是之后。
这个方法在 ScreenWeaver 之外也能用吗?
原则可以:每个角色一张多视角参考图,依据具体的描述生成,附在角色入画的每一次生成上,绝不用文字重新描写,通过测试后锁定。在别的工具里,你得手动管理设定图文件和引用,也没有机制拦下缺少参考图的镜头,所以纪律只能靠你自己。对动辄几十集的 AI 短剧来说,这份纪律更是省钱的关键。
Writing is free
Write your next script with ScreenWeaver
Write for free, export to PDF and Final Draft, and turn your scenes into a storyboard when you are ready.
Start writing free